1.1 什么是神经网络?
1.1.1 神经网络的基本概念和定义
最近几年,大模型无疑成为了最热门的技术方向。它并不是凭空诞生的,而是建立在人工智能发展的基础之上。支撑人工智能的一块重要“地基”,就是神经网络(Neural Network):一种受人脑神经元连接方式启发的数学结构。它并不是真的在复制大脑或“模拟思考”,而是在用大量简单计算单元处理数据、寻找规律。从图像识别到语音翻译,从自动驾驶到聊天机器人,许多重要的 AI 成果都离不开它。
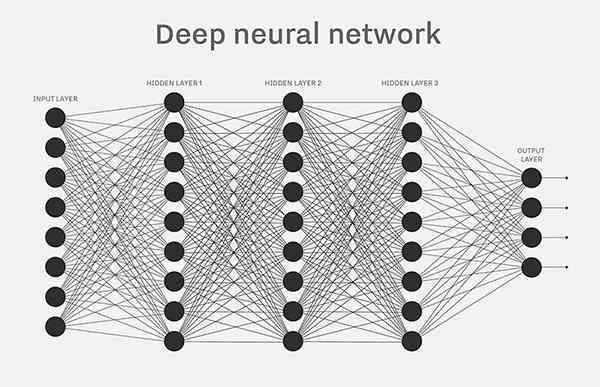
感知器
历史上,科学家一直希望模拟人的大脑,造出可以思考的机器。人为什么能够思考?科学家发现,原因在于人体的神经网络。
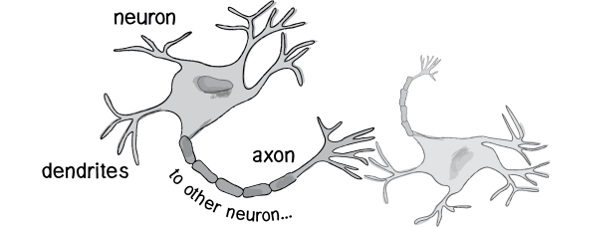
- 外部刺激通过神经末梢,转化为电信号,转导到神经细胞(又叫神经元)。
- 无数神经元构成神经中枢。
- 神经中枢综合各种信号,做出判断。
- 人体根据神经中枢的指令,对外部刺激做出反应。
既然神经元会接收信号、综合信号再给出反应,科学家便尝试设计“人造神经元”(artificial neuron)。把许多个这样的小计算单元连接起来,就得到人工神经网络。20 世纪 50 年代,研究者提出了早期的“感知器”模型(perceptron)。它比今天的大模型简单得多,却很适合帮助我们理解神经网络最基本的计算方式。
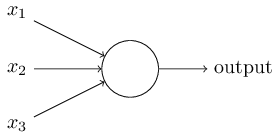
上图的圆圈就代表一个感知器。它接受多个输入(x1,x2,x3…),产生一个输出(output),好比神经末梢感受各种外部环境的变化,最后产生电信号。
为了简化模型,我们先约定每种输入只有两种可能:1 或 0。1 表示这个条件成立,0 表示不成立。注意:输入全为 1 时是否输出 1,并不是感知器天生规定好的,还要看每个条件的权重和最后设定的阈值。下面会用具体数字把这件事算出来。
感知器的例子
下面来看一个例子。城里正在举办一年一度的游戏动漫展览,小明拿不定主意,周末要不要去参观。
他决定考虑三个因素。
- 天气:周末是否晴天?
- 同伴:能否找到人一起去?
- 价格:门票是否可承受?
这就构成一个感知器。上面三个因素就是外部输入,最后的决定就是感知器的输出。我们把“去参观”记为输出 1,把“不去参观”记为输出 0。至于哪种输入组合会得到 1,要由下面的权重和阈值共同决定。
上面例子中,如果某些因素成立,另一些因素不成立,输出是什么?比如,周末是好天气,门票也不贵,但是小明找不到同伴,他还要不要去参观呢?
现实中,各种因素很少具有同等重要性:某些因素是决定性因素,另一些因素是次要因素。因此,可以给这些因素指定权重(weight),代表它们不同的重要性。
天气:权重为8
同伴:权重为4
价格:权重为4
上面的权重表示,天气是决定性因素,同伴和价格都是次要因素。
如果三个因素都为1,它们乘以权重的总和就是 8 + 4 + 4 = 16。
如果天气和价格因素为1,同伴因素为0,总和就变为 8 + 0 + 4 = 12。
这时,还需要指定一个阈值(threshold)。在本例中,如果总和大于或等于阈值,感知器输出 1;否则输出 0。
假定阈值为8,那么 12 > 8,小明决定去参观。
阈值的高低代表了意愿的强烈,阈值越低就表示越想去,越高就越不想去。
上面的决策过程,使用数学表达如下:
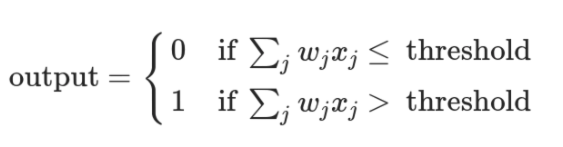
上面公式中,x表示各种外部因素,w表示对应的权重。

决策模型
上述案例中是单个感知器,单个感知器构成了一个简单的决策模型,但在真实世界中,实际的决策模型则要复杂得多,是由多个感知器组成的多层网络。
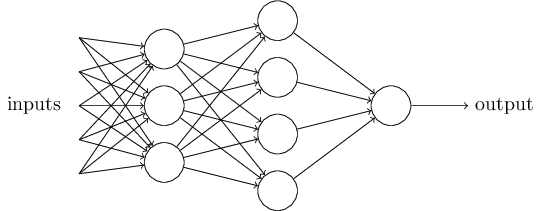
我们用「小明选择周末活动」的例子来解释多层感知器(Multi-Layer Perceptron, MLP),这个例子会展示分层决策的过程。
假设小明周末有两个备选活动:
- A. 参加游戏动漫展 (需要好天气、朋友同行、门票便宜)
- B. 宅家打游戏 (无需外部条件,但可能无聊)
他需要综合更复杂的因素来决定,于是构建了一个两层决策模型 :
第一层:基础条件判断
输入层 :原始因素(天气、同伴、门票价格、游戏新进度)
- 天气(晴天=1,权重5)
- 同伴(有朋友约=1,权重3)
- 门票价格(便宜=1,权重2)
- 是否有新游戏(有新游戏=1,权重5)
隐藏层:两个子决策节点
节点1:是否适合出门?
- 权重:天气×5 + 同伴×3 + 门票价格×2
- 阈值=6 → 总分≥6才考虑出门(天气最重要,同伴其次,价格最次要)
节点2:是否宅家?
- 权重:游戏新进度×5,阈值=3 → 只要有新游戏就吸引人
示例计算 :
假设天气=1(晴天),同伴=0(没人约),门票价格=1(便宜),是否有游戏=1(买了新游戏)
节点1:5×1 + 3×0 + 2×1 = 7 ≥ 6 → 输出 = 1(适合出门)
节点2:5×1 = 5 ≥ 3 → 输出 = 1(宅家也有吸引力)
第二层:最终决策
输出层:接收两个节点的输出(0 或 1),做出最终选择
- 权重:节点1输出×7 + 节点2输出×5
- 阈值=8 → 总分≥8选择出门,否则宅家
继续上例:节点1输出=1,节点2输出=1
总分 = 1×7 + 1×5 = 12 ≥ 8 → 选择出门!
假设天气=0(下雨),其他条件不变:
- 节点1:5×0 + 3×0 + 2×1 = 2 < 6 → 输出 = 0(不适合出门)
- 节点2:5×1 = 5 ≥ 3 → 输出 = 1(宅家有吸引力)
- 总分 = 0×7 + 1×5 = 5 < 8 → 宅家
天气一变,节点1的输出从1变成0,出门的“说服力”消失,最终决策随之改变。
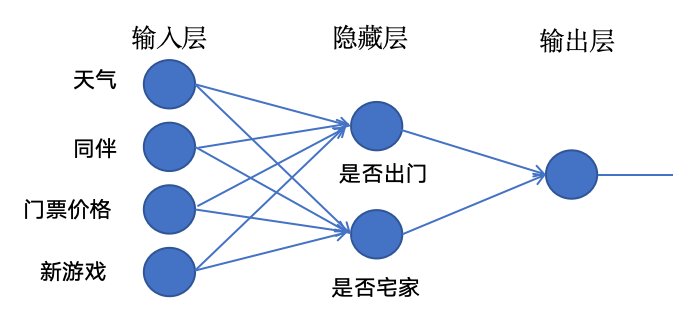
回过头来看这个决策过程,它的结构已经和神经网络高度相似:输入层接收原始信息,隐藏层对信息进行分组加工,输出层综合结论给出最终答案。每一层的每个节点,本质上都在做同一件事——对输入加权求和,与阈值比较,输出0或1。
真实的神经网络,可以看作把这个结构大规模扩展:隐藏层可以有很多层,每层可以有很多节点,输入也可以从 4 个因素变成图像的数百万像素、或文本中的许多词。更多层和节点让网络有能力表达更复杂的模式,但不保证一定学得更好,还需要合适的数据和训练方法。“深度学习”里的“深度”,主要指隐藏层的层数。
小明做决策时,权重和阈值是人为设定的。而神经网络的训练过程,就是让计算机通过大量数据,自动找到能让预测更准确的一组权重,不需要人逐一指定。实际程序里,阈值通常会改写成一个可学习的“偏置”参数,一起调整。这个自动调整参数的过程,就是后续要讲的反向传播与梯度下降的核心任务。
1.2 神经网络是如何学习的?
上一节留下了一个问题:小明网络里的权重和阈值都是人为设定的,我们掰着手指头就能把它们定下来。但真实的神经网络动辄几十层、上百万个权重,靠人来逐个指定是不可能的。怎么办呢?
答案是让网络自己学:用大量数据反复练习,答错了就调整权重,越练越准。
这个自动调整权重的过程,叫做训练(training)。
本节要讲的正向传播、损失函数、反向传播和梯度下降,合在一起完成的正是这件事。我们继续用小明的故事,把它们一个个讲清楚。
1.2.1 正向传播
正向传播
我们先回顾一下上一节“决策模型”的计算过程:数据从输入层进来,逐层加权求和,与阈值比较,最后从输出层给出答案。这个完整的计算过程,就叫做正向传播(forward propagation)。
也就是说,网络每做一次预测,其实就是做了一次正向传播。名字里的“正向”指的是数据的流动方向:从输入层流向输出层,就像信息在大脑中从感官流向决策。
激活函数
在上一节的决策模型里,每个节点的输出只有 0 和 1 两种可能,像是一个开关:条件够了就输出 1,不够就输出 0。
开关有一个问题:它只能说“去”或者“不去”,说不出“有多想去”。而学习恰恰需要知道“差多少”。同样是答错,差一点点和差得很远,纠正的力度应该不一样。如果输出永远只有 0 和 1,网络就分不清自己到底错得多严重,调整权重也就无从谈起。
因此,真实的神经网络在加权求和之后,通常还会多做一个处理:把总和交给一个激活函数(activation function)。激活函数有多种。本节为了讲清“去”还是“不去”这个二选一的例子,选用会输出 0 到 1 连续分数的 Sigmoid 函数。
最经典的激活函数是 Sigmoid 函数:
σ(z) = 1 / (1 + e^(−z))
不需要记住这个公式,只要理解它的作用:把任意大小的一个总分 z,压缩成一个 0 到 1 之间的输出分数。总分越大,分数越接近 1;总分越小,分数越接近 0。在经过合适训练和校准的二分类任务中,它可以近似理解为“属于正类的概率”,但此处先把它理解为网络的倾向程度就够了。我们挑两个值手算一下:
当 z = 2 时,σ(2) = 1 / (1 + e^(−2)) ≈ 0.88,网络的态度是强烈倾向“去”。
当 z = −2 时,σ(−2) = 1 / (1 + e^2) ≈ 0.12,网络的态度是强烈倾向“不去”。

上面的动图把这个函数完整地画了出来:横轴是加权求和得到的总分 z,纵轴是激活之后的分数 σ(z),图中两颗红星就是刚才手算的那两个点。请留意曲线的形状,它在 z = 0 附近最陡,总分在这里轻轻一变,分数就会大幅摆动;而总分很大或很小时,曲线几乎平了,分数基本不再变化。
手算一次预测
为了手算看得清,我们把小明的网络暂时简化一下:只保留一个节点、两个输入(天气和同伴),两个权重先随便设为 −1 和 −1。真实的神经网络在训练开始前,正是用随机数来初始化权重的,一开始预测得准不准,全看运气。
训练样本来自小明的真实经历:某个周末,天气晴(天气 = 1),朋友也约好了(同伴 = 1),小明去看了漫展。这条真实经历就是“正确答案”,记为 y = 1,表示小明去了。
现在,让网络对这条样本做一次正向传播,猜一猜小明去不去:
第一步,加权求和:z = 1×(−1) + 1×(−1) = −2。
第二步,激活打分:σ(−2) ≈ 0.12。
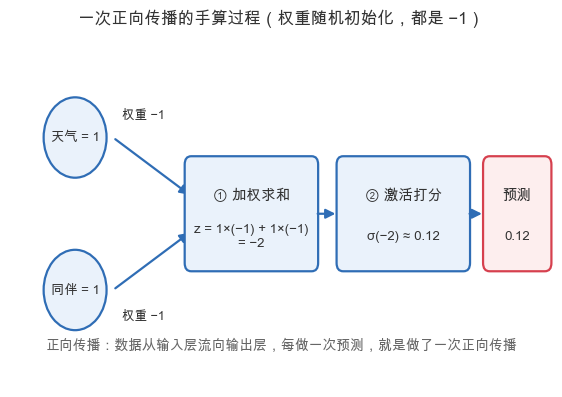
上图就是这次预测的完整过程。网络的判断是:小明“去漫展”的可能性只有 12%。可事实上,小明去了。预测和事实差得很远,不过这正是学习的机会:接下来要做的,就是让网络从这次错误中学到东西。
1.2.2 损失函数
预测是 0.12,正确答案是 1,两者差了 0.88。要让计算机自动纠错,光知道“错了”还不够,还得把“错了多少”变成一个具体的数字,计算机才能比较、才能优化。负责做这件事的,就是损失函数(loss function)。
为了延续刚才的手算例子,我们先使用平方误差:把“正确答案减去预测”的差平方一下。它很直观,适合观察误差如何变大或变小:
损失 = (正确答案 − 预测)²
代入刚才的例子:损失 = (1 − 0.12)² ≈ 0.77

上图画的是损失随预测值变化的曲线:预测越接近正确答案 1,损失越小;越偏离,损失越大。刚才那次预测(0.12)就落在曲线左上方的红星位置,损失高达 0.77。
为什么要平方一下,而不直接用差值呢?有两个原因。第一个原因,平方把正负误差统一成了“距离”:预测比答案高出 0.88 也好,低出 0.88 也好,平方之后都是 0.7744,只看差多少,不看偏高还是偏低。第二个原因,平方会放大大错误、缩小小错误:差 0.4 的损失只有 0.16,差 0.8 的损失是 0.64,错误翻一倍,损失翻到四倍。错得越离谱,损失涨得越猛,网络自然就越优先纠正它。
补充一个实际使用中的选择:本例是“去”或“不去”的二分类任务,工程中常把 Sigmoid 与二元交叉熵损失配合使用;预测连续数值(如房价)时,平方误差更常见。这里继续使用平方误差,只是为了让整段手算保持简单、前后一致。
有了损失函数,训练神经网络的目标就可以写成了这样一句话:调整所有权重,让损失尽可能小。我们可以把每一个权重想象成一个旋钮,损失就是仪表盘上的读数。接下来的两个概念,回答的正是两个问题:每个旋钮该往哪个方向拧,这是反向传播的事;每次拧多少,这是梯度下降的事。
1.2.3 反向传播
单个权重该怎么调
先看最简单的情形。要让预测从 0.12 提上去,我们可以倒着推理一遍:想让分数变大,总分 z 就要变大;而 z 是两个输入加权求和得来的,所以两个权重都应该调大一些。
再想细一点。这条样本里,天气 = 1,同伴 = 1,两个输入都参与了打分,两个权重都有责任,所以一起上调。但请换一个场景想一想:如果某个周末没有人约小明(同伴 = 0),那么不管同伴的权重是多少,它对总分都没有贡献。一个没有参与打分的因素,就不该为这次的错误负责,它的权重这次就不应该动。
把这个思路推广开来,就是反向传播(backpropagation):从输出端的误差出发,逆着数据的流向,一层一层往回推,算出每一个权重应该调整的方向和幅度。“反向”两个字,指的正是误差回传的方向:正向传播时,数据从输入流向输出;反向传播时,误差从输出流回输入。
多层网络的责任分摊
回到上一节小明的完整决策网络:天气、同伴、门票三个输入,先进入隐藏层的节点 1(是否适合出门),节点 1 的输出再乘以权重 7,进入最终的决策。如果最终决策错了,责任并不只在输出层。
输出层的权重 7 和权重 5,直接参与了最终打分,有责任;
隐藏层节点 1 的三个权重(天气×5、同伴×3、门票×2),决定了节点 1 往输出层送出什么样的信号,同样有责任。
反向传播做的事情,就是根据每个权重对损失的影响,把总误差一层层传回去,让网络里的每一个权重都收到一张“责任单”:自己该上调还是下调,该调整多少。这个影响大小要用到微积分里的导数来计算。先记住结论:反向传播负责算出每个权重的梯度,也就是调整方向和调整幅度的依据;真正按梯度改参数的动作,由下一个概念梯度下降来完成。
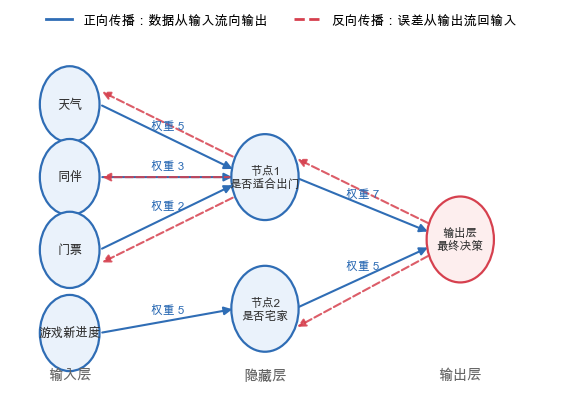
上图把两个方向都画了出来:蓝色实线是正向传播,数据从输入层流向输出层;红色虚线是反向传播,误差从输出层往回传,先落到输出层的权重 7 和权重 5 头上,再继续往回传到隐藏层节点 1 的权重 5、3、2 头上,一层都跳不过去。
1.2.4 梯度下降
蒙眼下山
账算好了,接下来真的要动手调整权重。这里借助一个经典的比喻:蒙眼下山。
把网络里全部权重合在一起,想象成地图上的一个位置;把损失想象成这个位置的海拔高度。训练的目标,就是从当前的位置出发,走到海拔最低的那个谷底。麻烦在于,我们蒙着眼睛,看不见整张地图,只能感觉到脚下的坡度:哪个方向是下坡,坡有多陡。
怎么办呢?办法很朴素:朝着最陡的下坡方向迈一小步,再感受一下新的坡度,再迈一步。反复这样做,损失通常会逐渐变小。这个方法就是梯度下降(gradient descent)。在真实的大网络里,地形可能有多个山谷,不能保证每次都到达全局最低点;但这个比喻足以帮助我们理解“朝让损失下降的方向走”。
梯度:当前位置上最陡的上坡方向。反向传播算出来的,正是每个权重上的梯度。
下降:我们不走上坡,而是沿梯度的反方向走,也就是下山。
终点:接近一个平坦区域时,坡度往往会变缓,每一步走出的距离也会变小;当权重几乎不再变化时,我们说训练接近收敛。
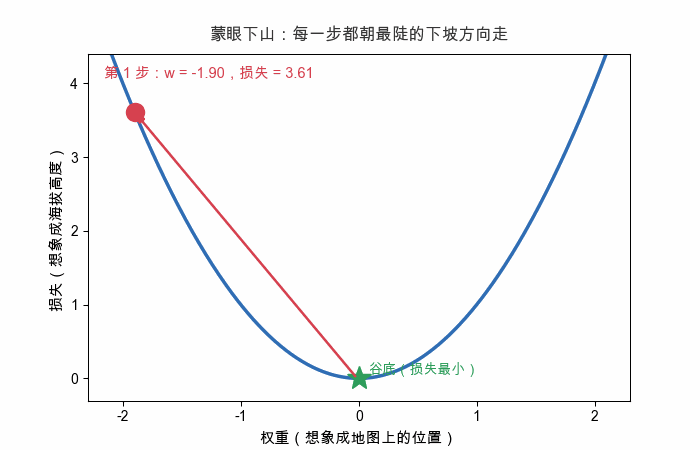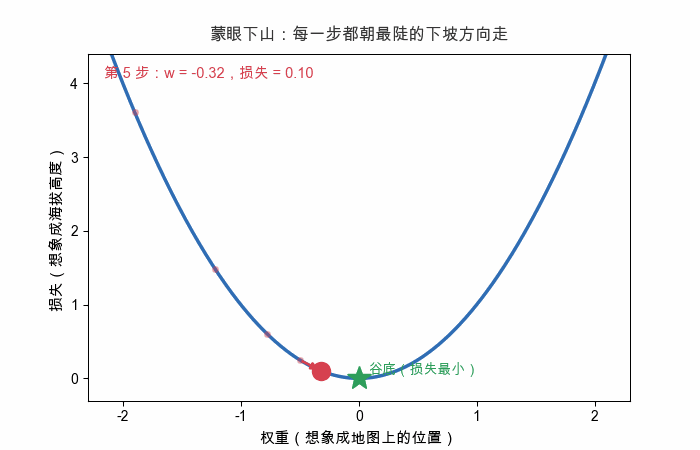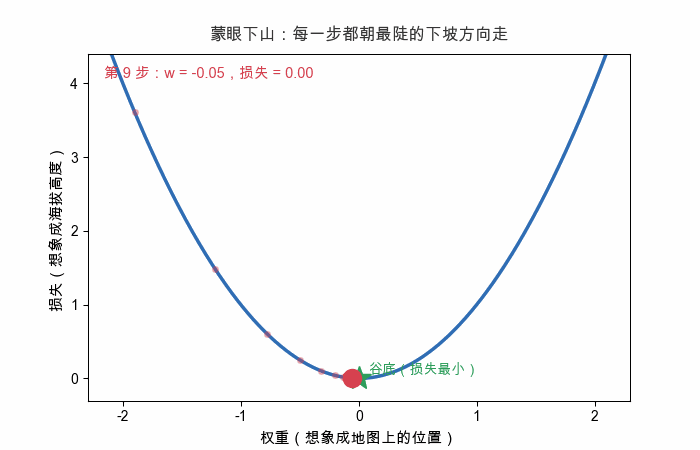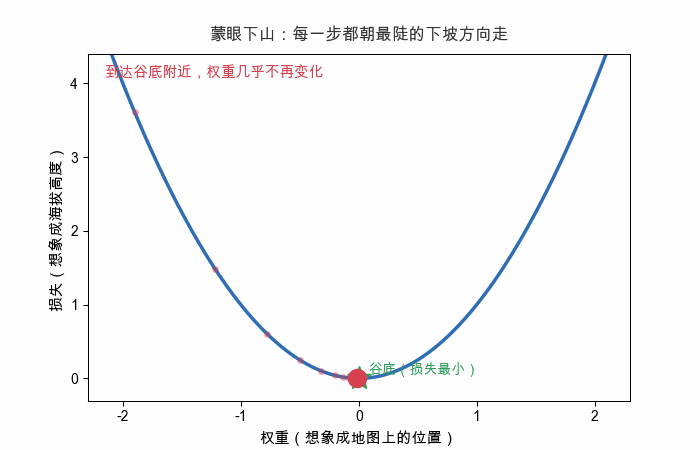
上面的动图演示了这个过程:小球从损失曲线的高处出发,每一步都沿着最陡的下坡方向走。可以观察到,离谷底越近,坡度越缓,小球的步子也自动越小,最后稳稳停在损失最小的位置。
学习率
每一步迈多大,由一个专门的数量来控制,它叫做学习率(learning rate),通常是一个比较小的小数,比如 0.1。
我们接着手算的例子走一轮。前面已经把损失定义为平方误差,把输出定义为 Sigmoid 分数。要完全遵守这两个定义,权重的梯度要把三个信息乘在一起:
梯度 = 2 ×(预测 − 正确答案)× 预测 ×(1 − 预测)× 输入
这个式子不用背。它只是把“错的方向和大小”“Sigmoid 在当前位置有多敏感”“这个输入有没有参与本次计算”合在一起。实际写 PyTorch 程序时,backward() 会自动完成这一步。
取学习率 0.1。初始预测为 0.119,正确答案为 1,天气和同伴两个输入都为 1:
梯度 = 2 × (0.119 − 1) × 0.119 × (1 − 0.119) × 1 ≈ −0.185
新权重 = 旧权重 − 学习率 × 梯度
天气的权重:−1 − 0.1 × (−0.185) ≈ −0.982
同伴的权重:−1 − 0.1 × (−0.185) ≈ −0.982
用新权重重新预测一遍:z ≈ −1.963,σ(−1.963) ≈ 0.123。预测分数从 0.119 增加到 0.123,损失也从 0.776 降到 0.769。变化不大,正好体现了“走一小步”的意思。下面把同一条训练数据重复学习五次,观察趋势:
| 第几次预测 | 预测分数 | 损失 |
|---|---|---|
| 第 1 次 | 0.119 | 0.776 |
| 第 2 次 | 0.123 | 0.769 |
| 第 3 次 | 0.127 | 0.762 |
| 第 4 次 | 0.132 | 0.754 |
| 第 5 次 | 0.136 | 0.746 |
可以看到,“学习”不是一次把答案改对,而是靠一次次小步修正,让预测慢慢靠近正确答案。真实训练会轮流使用大量不同的数据,而不是只重复这一条。
那么,学习率是不是越大越好呢?并不是,它的取值是门手艺:
学习率太大,一步就迈过了谷底,落到对面的山坡上,损失不降反升,在山谷两边来回震荡;
学习率太小,每步只挪一点点,训练要花非常久,可能数据都训完了,还没走到谷底。

上图把三种情况画在了一起。实际训练时,人们通常从 0.1 或 0.01 这样的数值试起,观察损失下降的情况,再决定调大还是调小。
完整的训练过程
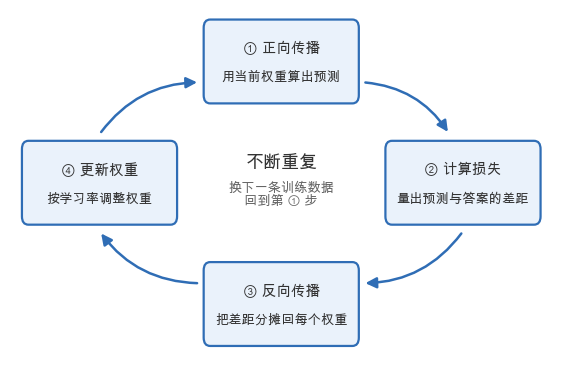
最后,把本节的四个概念串起来。神经网络的训练,就是下面这个不断重复的循环:
- 正向传播:用当前的权重算出预测值;
- 计算损失:用损失函数量出预测与正确答案的差距;
- 反向传播:把差距分摊回每个权重,算出各自的梯度;
- 更新权重:沿梯度反方向、以学习率为步长调整权重;
- 换下一条训练数据,回到第 1 步,继续下一轮。
训练数据完整地过一遍,称为一个 epoch。需要训练多少个 epoch 没有固定答案,要看数据量、模型大小和效果而定。训练过程中会持续观察损失和验证效果,再决定是否继续。